כשהמקור הוא בוט: כיצד אנשים מחליטים אם המידע שמתקבל מהבינה המלאכותית הוא נכון?

כיצד אנשים מעריכים מידע מדעי שנוצר באמצעות Bing Chat בהשוואה למידע שמוצג בתוצאות החיפוש בגוגל? ככל שבינה מלאכותית גנרטיבית (GenAI) מפיצה ויוצרת יותר ויותר תוכן מדעי, מיטשטש הגבול בין מקורות מומחים למקורות שאינם מומחים. המחקר הנוכחי בוחן כיצד משתמשים מתאימים אסטרטגיות הערכה – הערכת תוכן, הערכת מקורות והצלבת מקורות – לשימוש בכלי בינה מלאכותית לעומת מנוע חיפוש.

ד"ר שקד דברן־זיוון, ד"ר ענבל קליין־אברהם ופרופ' אילת ברעם־צברי | 04.10.2026

הרשמה לעדכונים מקצועיים

מבוא

המרחב הדיגיטלי שבו אנו מוצאים מידע, מעבדים, משתפים, יוצרים ומעבירים אותו, מתפתח ללא הרף, ובהתאם לכך עלינו לפתח גם את המיומנויות הדרושות כדי להתמצא בו. מיומנויות של הערכת מידע הן חיוניות בנוף הדיגיטלי המתרחב של ימינו, שבו המשתמשים נדרשים לעיתים קרובות לקבוע בעצמם עד כמה המידע מהימן, ואילו תפקידם של שומרי הסף המקצועיים הולך ומצטמצם.

מודלים מסורתיים להערכת אמינות מידע פותחו עבור סביבות שבהן המידע נוצר בידי בני אדם ומקורו היה ברור יחסית, כך שהמשתמשים יכלו להסתמך על סימנים כמו שם המחבר, שיוך מוסדי או ביקורת עמיתים כדי להעריך את מהימנותו. אולם השימוש ההולך וגובר ב־GenAI משנה את התנאים הללו. כאשר מידע נוצר או מוצג באמצעות מערכות בינה מלאכותית, לעיתים קרובות לא ברור מהם מקורות המידע שעליהם התבססה המערכת, כיצד הוא נוצר או מי אחראי לו. בסביבה כזו, קשה יותר להשתמש באסטרטגיות המסורתיות ששימשו עד כה להערכת האמינות של המידע.

על פי תיאוריית התהליך הכפול (Dual process theory), אנשים מעריכים מידע באמצעות שתי מערכות חשיבה: "מערכת 1", שהיא אינטואיטיבית ומהירה, ו"מערכת 2", שהיא איטית, אנליטית ורפלקטיבית יותר.[1] בסביבות מקוונות, המעודדות מהירות ומאמץ מזערי, משתמשים נוטים להסתמך על חשיבה מסוג מערכת 1 ולבצע שיפוטי אמינות מהירים, החשופים להטיות קוגניטיביות, כגון הטיית אישוש – הנטייה להעדיף מידע התואם עמדות קיימות ולהתעלם ממידע הסותר אותן.[2] לעומת זאת, חשיבה מסוג מערכת 2 מעודדת בחינה ביקורתית ומכוונת יותר, הכוללת עצירה לצורך הטלת ספק, אימות והשוואת מידע.[3] מחקרים מצביעים על מספר אסטרטגיות הערכה הדורשות מעורבות קוגניטיבית עמוקה יותר, ובהן הערכת תוכן, הערכת מקורות ואימות המידע מול מקורות אמינים נוספים.[4]

לפי מחקרים עדכניים, הערכת מקורות היא אסטרטגיה מרכזית בהקשר של הערכת מידע מדעי מורכב. זאת בשל התלות האפיסטמית של אנשים שאינם מומחים, כלומר הסתמכותם על גורמים מתווכים הנתפסים כמהימנים, משום שאין ביכולתם לאמת בעצמם את הטענות המדעיות.[5] אולם הופעתה של הבינה המלאכותית היוצרת מציבה אתגר בפני אסטרטגיות אלו, שכן מקור המידע הוא מערכת הבינה המלאכותית עצמה, כאשר הנתונים המשמשים לאימונה ותהליכי יצירת התוכן שלה לרוב אינם גלויים למשתמשים. כתוצאה מכך, סימני האמינות המסורתיים נעדרים לעיתים קרובות ממידע זה. יתרה מזאת, "השטחת המומחיות" לא רק מטשטשת את ההבחנה בין מקורות מומחים למקורות שאינם מומחים, אלא גם מגבירה את תלותם של משתמשים בקופסאות שחורות, שאופן פעולתן וההיגיון המנחה אותן נסתרים מפניהם. התפתחויות אלו מעוררות קשיים בכל הנוגע לאימות מידע ולייחוסו למקור מסוים, ומעלות שאלות לגבי יישום אסטרטגיות הערכה קיימות בסביבות מידע בתיווך בינה מלאכותית.[6]

על רקע העלייה בהיקף המידע הכוזב, עולה הצורך להבין כיצד אנשים מעריכים מידע שנוצר בידי בינה מלאכותית. מעבר להבנת דרך הפעולה הכללית של מערכות כאלה, על משתמשים להכיר גם במגבלות שלהן. מגבלות אלו כוללות חוסר שקיפות לגבי אופן פעולת האלגוריתמים, הטיות אפשריות במידע ששימש לאימון המערכות,[7] וכן נטייה ל"הזיות" של המערכת – היא עלולה לספק תשובות שנראות אמינות ומשכנעות, אך בפועל אינן נכונות.[8] אף שבמחקרים קודמים נבדקו תפיסות של אנשים לגבי בינה מלאכותית יוצרת מבחינת הוגנות, אחריות ושקיפות,[9] לא ידוע לנו הרבה על האופן שבו משתמשים מעריכים בפועל את המידע שמערכות אלו מספקות.

לפיכך, מטרת המחקר היא לבחון כיצד אנשים מעריכים מידע בעת שימוש ב־GenAI, בהשוואה להערכתו כאשר הם משתמשים במנוע חיפוש רגיל, בהקשרים של דילמות מדעיות יום־יומיות. לצורך ההשוואה בחרנו ב־Bing Chat של מיקרוסופט (היום Copilot) כמערכת בינה מלאכותית יוצרת, ובגוגל כמנוע חיפוש מסורתי. להשוואה בין שתי הפלטפורמות יש חשיבות משום שהן מציגות מידע בדרכים שונות: Bing Chat מספק תשובות ישירות בממשק שיחתי ומשלב בהן קישורים למקורות, ואילו בגוגל מוצגת רשימה של מקורות חיצוניים, והמשתמש נדרש להיכנס אליהם, לקרוא בהם ולהעריך אותם בעצמו. בשני המקרים המשתמשים יכולים לגשת למקורות מידע, אך יש הבדלים מהותיים באופן הגישה למידע ובאינטראקציה איתו. ההשוואה מאפשרת לנו לבדוק כיצד אנשים משתמשים באסטרטגיות הערכה בכל אחת מסביבות המידע. בהתאם לכך, שאלת המחקר המרכזית היא: כיצד אנשים מעריכים מידע מדעי שנוצר באמצעות Bing Chat בהשוואה למידע שמוצג בתוצאות החיפוש בגוגל?
מתודולוגיה

מחקר זה מתמקד בבינה מלאכותית יוצרת, ובפרט במודלי שפה גדולים (LLMs), המסוגלים לייצר תגובות כמו־אנושיות. הנתונים נאספו בין חודש יוני לחודש אוגוסט 2023 – תקופה שבה ChatGPT-3.5 עדיין לא פעל היטב בעברית, לא סיפק מקורות מידע, והיה מוגבל למידע שנאסף עד שנת 2021.[10] לכן בחרנו להשתמש ב־Bing Chat (היום Copilot), שהיה זמין לציבור דובר העברית, סיפק מידע עדכני והציג מקורות. גוגל נבחר משום שהוא מנוע החיפוש הפופולרי ביותר בישראל ובעולם.[11]

בזמן איסוף הנתונים, רוב האוכלוסייה הבוגרת בישראל (81%) השתמשה באינטרנט מדי יום.[12] עם זאת, השימוש בבינה מלאכותית יוצרת היה מוגבל יחסית: בשנת 2023, 77% ממשתמשי האינטרנט בישראל הכירו את התחום אך טרם השתמשו בכלים מסוג זה, ורק 16% דיווחו כי השתמשו בהם מספר פעמים.[13] מבין מי שהשתמשו בכלי בינה מלאכותית יוצרת, כשני שלישים השתמשו בהם לחיפוש מידע מדעי.[14] כמו כן, בשנת 2023 צ'אטים מבוססי בינה מלאכותית יוצרת היו בתחילת דרכם, וחלק מהתכונות המאפיינות אותם היום עוד לא היו זמינות. במחקר זה, כאמור, בחרנו ב־Bing Chat מכיוון שגם באותה תקופה הוא הציג את המקורות שעליהם התבסס וסיפק הפניות אליהם – תכונה הקיימת היום במרבית הצ'אטים. עם זאת, חשוב לזכור שגם כאשר הצ'אט מספק הפניות למקורות, סימני האמינות המסורתיים פחות נגישים למשתמש. שם המחבר או שם האתר, למשל, אינם מופיעים בהכרח באופן בולט כחלק מהתשובה. ההפניה אומנם קיימת, אך כדי לבחון את מקור המידע ואת אמינותו המשתמש נדרש לגשת אליה ולבדוק אותה במודע.

על בסיס נתונים אלו גיבשנו מדגם מגוון באמצעות דגימת מכסות.[15] המדגם כלל 30 משתתפים – סטודנטים לתואר ראשון ובוגרי תיכון, עם ובלי רקע מדעי, אשר חלקם בעלי ידע או ניסיון בתחום האלגוריתמים. כל המשתתפים נתנו הסכמה מדעת להשתתפות במחקר. המדגם הסופי כלל 63% נשים, וגיל המשתתפים נע בין 18 ל־39: 27% בני 18–22, 60% בני 23–29, ו־13% בני 30–39.

משימת הביצוע נועדה לבדוק כיצד המשתתפים מתמודדים עם דילמות חברתיות־מדעיות. בחלק הראשון של הפגישה הוצג בפני כל אחד מהם הקטע הבא, העוסק בדיאטות ניקוי רעלים:

"חברה קרובה, שבריאותה חשובה לה אך היא נמצאת בקשיים כלכליים, פונה אליך בשאלה: היא שוקלת לקנות ערכת ניקוי רעלים המבוססת על דיאטת מיצים, שאמורה להביא לשיפור מהיר בבריאות הגופנית ובמצב הרוח. החיסרון הוא מחירה הגבוה של הערכה. היא תוהה אם ניקוי הרעלים בטוח והאם הוא יהיה טוב עבורה. מה היית ממליץ לה לעשות?"

בחלק השני של המפגש התבקשו המשתתפים לבחור דילמה אחת מתוך עשר דילמות חברתיות־מדעיות, למשל: "האם עדיף להשתמש בכלים חד־פעמיים מפלסטיק או בכלים חד־פעמיים מתכלים?". במהלך ביצוע המשימות, המראיינות עקבו אחר תהליך החיפוש והערכת המידע של המשתתפים וצפו באופן השימוש שלהם במערכות השונות. לאחר השלמת המשימות נערכו ראיונות חצי־מובנים, שנמשכו כשעה, ובהם המשתתפים תיארו את תהליכי חיפוש המידע והערכתו בעת השימוש בטכנולוגיות השונות (לתיאור מלא של מערך המחקר ראו תרשים 1).


תרשים 1: מערך המחקר

תרשים 1: מערך המחקר

בפרט, ביקשנו להבין באילו אסטרטגיות השתמשו המשתתפים כדי להעריך את המידע שקיבלו – הן בפועל, במהלך המשימה, והן דרך האופן שבו תיארו בראיונות את תהליך ההערכה. לצורך כך התמקדנו בשלושה סוגים מרכזיים של אסטרטגיות הערכה: הערכת תוכן (למשל, האם המידע נתפס כנכון או הגיוני), הערכת מקור (למשל, האם המקור נתפס כאמין או בעל מומחיות בתחום), והצלבת מקורות (למשל, האם מקורות אמינים נוספים תמכו במידע שהוצג).

ניתחנו את הנתונים באמצעות תוכנת ATLAS.ti ובשיטת ניתוח תמטי, שמטרתה לזהות דפוסים ורעיונות מרכזיים בדברי המרואיינים.[16] הניתוח התבסס על תמות שעלו מהנתונים עצמם, כמו גם על מושגים ממחקרים קודמים בתחום של הערכת מידע מקוון. בזכות השילוב בין תצפיות לראיונות התקבלה תמונה רחבה ואמינה של התנהגות המשתתפים.[17] במהלך המחקר ערכנו דיונים בצוות לבחינת הפרשנויות והמסקנות, וכן התייעצנו עם מומחים חיצוניים בתחום תקשורת המדע, אשר סיפקו משובים שסייעו לחזק את אמינות המחקר ואת הקפדנות המתודולוגית.[18]

ממצאים

אסטרטגיות הערכה ביקורתיות שיושמו בשתי הטכנולוגיות

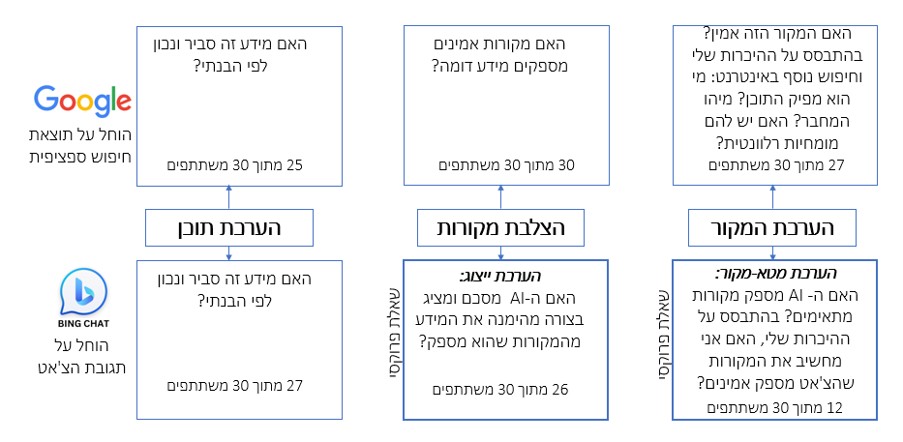
בבחינת אסטרטגיות הערכת המידע של המשתתפים בעת השימוש בגוגל וב-Bing Chat, התמקדנו כאמור בשלוש אסטרטגיות מרכזיות: הערכת התוכן עצמו, הצלבת מקורות והערכת מקור המידע. הממצאים מראים כי המשתתפים השתמשו בכל שלוש האסטרטגיות בשתי הפלטפורמות, אך היו הבדלים ניכרים באופן השימוש בהן בכל פלטפורמה (תרשים 2). ההבדלים הבולטים ביותר נמצאו בהצלבת המידע ובהערכת אמינותם של המקורות.

תרשים 2: אסטרטגיות הערכה ביקורתיות ויישומן במנוע חיפוש וב־GenAI

תרשים 2: אסטרטגיות הערכה ביקורתיות ויישומן במנוע חיפוש וב־GenAI


אסטרטגיית הערכת תוכן

בגוגל וגם ב־Bing Chat, רוב גדול של המשתתפים הסתמכו על ידע קודם להערכת סבירות המידע. תהליך הערכה זה, שהיה בעיקרו תרגיל מחשבתי, עלה במהלך ראיונות כאשר המשתתפים תיארו את הידע הקיים שלהם ואת השימוש שעשו בו. למשל, P2, סטודנטית לתואר ראשון במדעי התזונה, הסבירה: "ביססתי את הערכתי על הידע שקיבלתי בלימודי תזונה. אני מבינה שדיאטת ניקוי רעלים אינה בריאה ולכן אני לא ממליצה עליה".

אסטרטגיית הצלבת מקורות

במהלך התצפיות ראינו שכל המשתתפים בדקו לפחות שלושה מקורות שונים בעת החיפוש בגוגל. ייתכן שהנטייה לבצע אימות פעיל הושפעה מסביבת המחקר ומהאינטראקציה עם החוקרות,[19] אך ההתייחסות החוזרת של המשתתפים לאסטרטגיה זו בראיונות מעידה על המודעות שלהם לחשיבות של בדיקת מידע בכמה מקורות.

לעומת זאת, בעת השימוש ב־Bing Chat המשתתפים נטו להשתמש באסטרטגיה שונה, שאותה כינינו "הערכת ייצוג". במקום לבדוק האם כמה מקורות אמינים מציגים מידע דומה, הם בדקו האם הצ'אט סיכם בצורה מדויקת את המידע שהופיע במקורות שאליהם הפנה.

אסטרטגיה זו הייתה נפוצה יחסית: כמחצית המשתתפים נכנסו באופן פעיל לקישורים שהוצגו בצ'אט כדי לבדוק האם המידע במקורות תואם לתשובה שניתנה. חשיבותה של אסטרטגיה זו התבררה במהלך הראיונות, במיוחד כאשר המשתתפים דנו ביכולתם להעריך את התוכן שסיפק הצ'אט. P9, סטודנט לתואר ראשון במדעי המחשב, הסביר: "Bing Chat מספק את הקישורים, וזה מאוד נוח כי אני יכול להיכנס אליהם ולבדוק אם הם מאששים את המידע שסיפק הצ'אט" – מה שאכן עשה במהלך משימת הביצוע. P10, סטודנט לתואר ראשון בפיזיותרפיה, שנכנס לקישורים שהוצגו בצ'אט וקרא את התוכן הנוסף, ציין: "הסתמכתי על האתרים שאליהם הצ'אט הפנה אותי, פחות על התשובות של Bing Chat". רק ארבעה משתתפים לא התייחסו לאסטרטגיה זו כלל, לא בתצפיות ולא בראיונות.

אסטרטגיית הערכת מקורות

אסטרטגיית הערכת המקורות הופיעה בשתי צורות עיקריות במהלך החיפוש בגוגל: הערכת סוג האתר והערכת המחבר. בהערכת סוג האתר, משתתפים בחנו האם המקור נתפס כאמין – למשל אתר של משרד הבריאות, גוף רפואי מוכר או מאמר אקדמי. הערכת המחבר כללה בדיקה מי חיבר את התוכן ומהי המומחיות שלו בתחום. הערכת סוג האתר בלטה במיוחד בתצפיות: 23 משתתפים פנו באופן יזום למקורות רשמיים ואמינים, גם כאשר אלו לא הופיעו בראש תוצאות החיפוש. לעומת זאת, הערכת המחבר הוזכרה בראיונות יותר מאשר במהלך החיפוש עצמו. רק ארבעה משתתפים בדקו בפועל את זהות הכותב ואת הרקע המקצועי שלו. לדוגמה, P5, סטודנט לתואר ראשון במדעי המחשב, בדק מי כתב את המאמר שהוא קורא, והדגיש באמצעות העכבר שהמחברת היא תזונאית מוסמכת. חיפוש יזום אחר מידע על המחבר, כפי שמומלץ בספרות, נצפה רק במקרה של P6, רכזת פיתוח מקצועי במגזר ההיי־טק. משתתפת זו ציינה בריאיון: "בדקתי וראיתי שמי שכתבה את המאמר באתר הבריאות לא הייתה סתם מישהי, הייתה לה מומחיות מקצועית".

לעומת זאת, בעת השימוש ב־Bing Chat המשתתפים כמעט שלא העריכו את המקורות עצמם. במקום זאת הם השתמשו במה שכינינו "הערכת מטא־מקורות" – כלומר, בדקו האם המערכת בחרה מקורות שהיו לדעתם אמינים ומתאימים. במילים אחרות, במקום להעריך את המקור עצמו, הם העריכו את שיקול הדעת של המערכת בבחירת המקורות.

אסטרטגיה זו עלתה בעיקר בראיונות, כאשר המשתתפים הסבירו כיצד קבעו האם ניתן לסמוך על Bing Chat. לדוגמה, אחד המשתתפים ציין כי התאכזב מכך שהמערכת הפנתה אותו לאתרי חדשות ולא למקורות מדעיים. משתתף אחר הסביר כי קשה לו לסמוך על הצ'אט משום שלדבריו המקורות שהוא בוחר אינם מספיק טובים. נוסף על כך, אף משתתף לא שאל את Bing Chat מדוע בחר דווקא במקורות מסוימים או מהי מידת המומחיות שלהם. כאשר המשתתפים נכנסו למקורות, הם עשו זאת בעיקר כדי לבדוק האם התוכן תואם לתשובת המערכת, ולא כדי להעריך את אמינות המקור עצמו.

הסתמכות על הטיות קוגניטיביות בשתי הטכנולוגיות

כל המשתתפים השתמשו באסטרטגיות הערכה ביקורתיות, אך חלקם גם הסתמכו על הטיות קוגניטיביות בעת הערכת המידע. שתי הטיות היו בולטות במיוחד: הטיית אישוש והיריסטיקת מכונה. משתתפים שהציגו הטיית אישוש בעת השימוש בגוגל הציגו אותה גם בצ'אט. היריסטיקת מכונה, לעומת זאת, הופיעה בבירור רק בעת השימוש בצ'אט.

הטיית אישוש

הטיית האישוש באה לידי ביטוי באופן דומה בקרב 16 משתתפים בעת חיפוש מידע בנושא מסוים בשתי הפלטפורמות. במהלך משימת הביצוע, P13, צעיר מובטל בעל השכלה תיכונית, בחר בדילמה הקשורה לכלי אוכל חד־פעמיים. הדילמה הייתה: "מבחינת איכות הסביבה, האם עדיף להשתמש בכלי אוכל חד־פעמיים מתכלים מבמבוק, או בכלים חד־פעמיים מפלסטיק הניתנים למחזור?". אף שכלי אוכל רב־פעמיים לא הוזכרו בדילמה, לפני ש־P13 ביצע חיפוש כלשהו הוא הביע עמדה ברורה שיש להשתמש רק בכלי אוכל רב־פעמיים. לאחר מכן הוא פנה לחפש מידע רלוונטי לדילמה. לאחר שסקר את המקור הסופי שמצא בגוגל וגיבש המלצה, הוא ציין: "אבל אלה [כלי במבוק חד־פעמיים] בטח מזיקים לכדור הארץ. אני צריך למצוא כמה חסרונות [בשימוש בהם]". לאחר מכן הוא מיקד את החיפוש באמצעות הקלדת הביטוי "חסרונות של כלי אוכל מבמבוק". בסופו של דבר הוא המליץ ​​לחברו להשתמש בכלים רב־פעמיים, בהתאם לעמדתו המקורית. כאשר P13 ערך חיפוש ב־Bing Chat, הוא נתקל בתוכן דומה, התומך ביתרונות הסביבתיים של כלי אוכל מבמבוק. המראיינות הבחינו שכדי להמשיך ולאשש את אמונותיו, הוא הנחה במכוון את הצ'אט באמצעות השאלה "מהם החסרונות של כלי במבוק?".

היריסטיקת מכונה

היריסטיקת מכונה (Machine Heuristic) היא הטיה קוגניטיבית שבמסגרתה אנשים נוטים לתפוס מערכות אוטומטיות כאובייקטיביות ואמינות יותר מבני אדם, ולכן נותנים בהן אמון רב יותר. 12 משתתפים יישמו היריסטיקה זו בעת שימוש ב־Bing Chat. הדבר בא לידי ביטוי בדיון הרפלקטיבי במהלך הראיונות, כאשר משתתפים הסבירו מדוע הם סומכים על המידע שקיבלו מהצ'אט. P13, צעיר מובטל בעל השכלה תיכונית, ציין: "הטכנולוגיה הזו יודעת הכול. מה אני יודע לעומתה?". כששאלנו את P15, סטודנטית לתואר ראשון בעבודה סוציאלית, אם היא פקפקה במידע שסיפק הצ'אט, היא ענתה: "לא ממש, אולי כי זה מנוע חיפוש שמיועד לדברים האלה. אני לא יודעת, פשוט ממש סמכתי עליו". היריסטיקת המכונה זוהתה אך ורק במהלך הערכת המידע שסיפק Bing Chat ולא בעת הערכת מידע שהתקבל בחיפוש גוגל. אף שהמשתתפים סמכו על גוגל שיספק מקורות איכותיים בתוצאות המדורגות גבוה, הם גללו למטה וסקרו גם קישורים אחרים לפני שהחליטו לאילו אתרים להיכנס. הטיה זו עשויה לנבוע ממאפייני הממשק של הצ'אט, שכן הצ'אט הוא שמייצר את התוכן. כפי שציין P11, צעיר מובטל בוגר תיכון: "לא חשבתי להיכנס למקורות שהוא סיפק; פשוט סמכתי עליו".

דיון

החידוש באסטרטגיות ההערכה המוצגות במחקר זה טמון בביטויים הייחודיים שלהן בסביבת מידע בתיווך בינה מלאכותית. ביטויים אלה לא תוארו בספרות עד כה, והם נחשפים כאן בזכות ההצטלבות הייחודית בין חקירה קוגניטיבית לחקירה סוציו־טכנית.

הצלבת מקורות התגלתה כאסטרטגיה מרכזית להערכת מידע. כמחצית המשתתפים השתמשו במקורות שסיפק Bing Chat כדי לבדוק האם התשובה שלו תואמת למידע שמופיע בהם. עם זאת, במקום לבדוק האם מקורות אמינים נפרדים מאשרים מידע זה, המשתתפים נטו להשתמש במה שכינינו "הערכת ייצוג", כלומר בדקו האם הבינה המלאכותית סיכמה במדויק את המקורות שהציגה. גישה זו היא סוג של האצלת סמכויות אפיסטמית לבינה המלאכותית: המשתמשים למעשה הסתמכו על כך שהמערכת תבחר עבורם את המקורות ותבצע את עבודת האימות הראשונית. הבעיה היא שגם תשובות שגויות יכולות להיראות אמינות אם הן מבוססות על מקורות לא מהימנים או על סיכום מטעה של מקורות קיימים. מצב זה עלול להוביל להפצת מידע שגוי. בדומה לאופן שבו "תיבות תהודה" ברשת חושפות אנשים בעיקר למידע התואם את עמדותיהם,[20] גם מערכות בינה מלאכותית יוצרת עלולות להפנות משתמשים למקורות בעייתיים, שהמשתמשים לא יבדקו באופן עצמאי. מכיוון שהמשתתפים לא בחרו בעצמם את המקורות ששימשו לאימות המידע, הם נטו לראות בעצם הצגת המקורות ב־Bing Chat מעין אישור לכך שמדובר במקורות אמינים, אף שהמערכת אינה מוודאת בהכרח את אמינותם.

ההבדל הבולט ביותר בנוגע לשימוש בפלטפורמות השונות ניכר בהערכת מקורות מידע. בעת השימוש בצ'אט, המשתתפים נטו להשתמש במה שכינינו "הערכת מטא־מקורות". כלומר, הם העריכו את אמינות המערכת על סמך המקורות שהציגה, אך בלי לבדוק את המקורות עצמם לעומק. ברוב המקרים, ההערכה התבססה בעיקר על היכרות קודמת עם שם האתר או הדומיין שאליו הופנו. דפוס זה משקף תהליך של "העברת אמינות": האמון של המשתמשים בממשק הבינה המלאכותית הוחל גם על המקורות שהמערכת הציגה או ציטטה. ממצא זה תואם מחקרים קודמים,[21] שהראו כי כאשר גולשים מעריכים מידע מדעי ברשתות חברתיות, הם נוטים להסתמך בעיקר על היכרות עם המקור כסימן לאמינותו. למעשה, עצם ההיכרות עם מקור מסוים עשויה להביא לצמצום השימוש בקריטריונים נוספים להערכת אמינות המידע.

התאמות אלו מצביעות על מעבר חלקי מהערכה עצמאית של מידע להסתמכות על תיווך של טכנולוגיות. אומנם המשתתפים השתמשו באסטרטגיות הערכה בגוגל וגם ב־Bing Chat, אך בסביבת הבינה המלאוכתית אסטרטגיות אלו השתנו. במקום להעריך מידע באופן עצמאי, המשתתפים נטו להסתמך יותר על המערכת ועל הבחירות שהיא מבצעת עבורם.

ממצאים אלו מצביעים על כך שמודלים קיימים של הערכת מידע מקוון מתאימים חלקית בלבד לסביבות מבוססות בינה מלאכותית. המעבר ממנוע חיפוש כמו גוגל, שמציג רשימת מקורות ודורש מהמשתמש לבחור ולהעריך אותם בעצמו, למערכת כמו Bing Chat, שמספקת תשובות מסוכמות בממשק שיחתי, משנה לא רק את צורת הגישה למידע אלא גם את האופן שבו המשתמשים קובעים מה מידת האמינות של המידע. בעוד מבנה החיפוש של גוגל משמר מודל הערכה מבוזר ומבוסס מקור, ומעודד משתמשים לגשת למקורות וטקסטים שונים, המבנה הגנרטיבי של הצ'אט מטפח אשליה של מקור יחיד, וממצב את הבינה המלאכותית עצמה כשומר סף אפיסטמי.

שינוי זה ממחיש כיצד טכנולוגיות בינה מלאכותית יוצרת עשויות להפחית את האחריות הקוגניטיבית של המשתמשים להערכת מידע. הממצאים שלנו מצביעים על כך שאסטרטגיות הערכה מושפעות לא רק מנטיותיו האישיות של המשתמש, אלא גם מעיצוב הפלטפורמה ומהאופן שבו המידע מוצג בה. מאפייני הממשק משפיעים על רמת האמון של המשתמשים במידע, כמו גם על מידת האחריות שהם מקבלים על עצמם להערכתו. לכן, עולה צורך לפתח מסגרות הערכה המותאמות לסביבות מידע מבוססות בינה מלאכותית יוצרת, תוך התחשבות במגבלות האפיסטמיות של טכנולוגיה זו.[22]

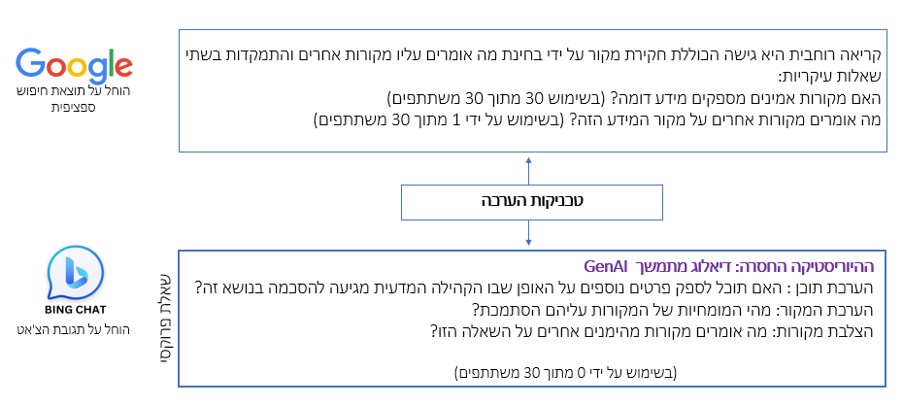
ההיוריסטיקה החסרה: דיאלוג מתמשך עם הצ'אט על תשובותיו ומקורותיו

כלי בינה מלאכותית יוצרת הרחיבו את התפקידים שממלאת הבינה המלאכותית אל יישומים מבוססי דיאלוג.[23] אינטראקציה דיאלוגית יכולה לשפר את איכות המידע והתמיכה שהמערכת מספקת, משום שהיא מאפשרת התאמה אישית של התשובות על בסיס מהלך השיחה והתגובות של המשתמש.[24] דיאלוג כזה עשוי גם לסייע בזיהוי שגיאות.

אף שכל המשתתפים ניהלו דיאלוג עם הצ'אט ושאלו לפחות שתי שאלות בנושא הנחקר, ורבים מהם אף שאלו שאלות נוספות, הם לא נקטו שיטות אימות מעמיקות יותר. בשונה מהתנהגותם בעת השימוש בגוגל, אז הם הטילו ספק לעיתים קרובות באמינות המקורות או השוו את המידע שהתקבל דרך תוצאות שונות, בסביבת הצ'אט הם נטו לקבל את התשובות כפי שניתנו. בעוד לאינטראקציה דיאלוגית יש פוטנציאל לשמש מנגנון מטא־קוגניטיבי לבדיקת טענות ולהתעמקות באי־ודאות, רוב המשתתפים התייחסו לדיאלוג עם הצ'אט כפונקציונלי ולא אפיסטמי. כאשר המשתתפים חיפשו מידע בממשק הצ'אט, הם הסתמכו במקרים רבים על התשובות שקיבלו, בלי לבחון לעומק את המקורות שסופקו ובלי לשאול את הצ'אט עליהם, על מידת אמינותם או על הסיבות לבחירתם (תרשים 3).

תרשים 3: נוהלי הערכה ויישומם באמצעות מנוע חיפוש וכלי בינה מלאכותית יוצרת

תרשים 3: נוהלי הערכה ויישומם באמצעות מנוע חיפוש וכלי בינה מלאכותית יוצרת


דיאלוג עם GenAI עשוי לשפר את יכולתם של משתמשים להעריך מידע בביקורתיות. באופן אידיאלי, משתמשים יכולים להנחות את המערכת לספק מידע מפורט ומבוסס יותר, למשל באמצעות שאלות כמו "אילו ראיות תומכות בטענה הזו?" לצורך הערכת התוכן. ניתן גם לשאול על מידת ההסכמה בנושא מסוים, למשל: "האם קיים קונצנזוס בקהילה המדעית בנושא הזה?".

כמו כן, שאלות מבוססות דיאלוג עשויות לתמוך בהערכת מקורות, למשל: "מהי המומחיות של המקורות שעליהם הסתמכת?" או "מה נאמר במקורות אמינים אחרים על הנושא הזה?". שימוש בטכניקות הערכה מסוג זה עשוי לסייע למשתמשים לפתח מיומנויות חשיבה ביקורתית והערכת מידע בסביבות GenAI, ולהקל על המעבר מחיפוש מידע במנועי חיפוש מסורתיים לחיפוש מבוסס בינה מלאכותית.

סיכום

ככל שהאחריות האפיסטמית מועברת למערכות אלגוריתמיות, מתחוללים שינויים במודלים קיימים של הערכת אמינות ואימות מידע, מה שמדגיש את הצורך לחשוב מחדש על מושגים אלו בסביבות מידע בתיווך בינה מלאכותית. ממצאינו מראים כי אסטרטגיות הערכה שפותחו בסביבות של מנועי חיפוש אינן מועברות אוטומטית לממשק החדש. במקום ליישם אותן אסטרטגיות בממשק חדש, המשתתפים התאימו את שיטות ההערכה הקיימות שלהם לפלטפורמה. התאמות אלו ממחישות כיצד תפיסות של אמון, אמינות ואימות מידע משתנות בהקשר של בינה מלאכותית, וכיצד האחריות להערכת מידע מועברת בהדרגה מהמשתמש למערכת. ממצאים אלו מוסיפים רובד חדש להבנה התיאורטית של האופן שבו אנשים מתמודדים עם שאלות של סמכות, אחריות ואמינות כאשר מקור המידע עצמו הוא מערכת המבוססת על אלגורתמים.

לקריאת המאמר בגרסתו המלאה ראו: Dabran-Zivan S, Klein-Avraham I, Baram-Tsabari A (2026) Correction: When the source is a bot: How people adapt their evaluation strategies to assess AI-generated content. PLOS ONE 21(4): e0348712. https://doi.org/10.1371/journal.pone.0348712.

מקורות

[1] Kahneman D. Thinking, fast and slow. Macmillan. 2011.

[2] Britt MA, Rouet JF, Blaum D, Mills K. A reasoned approach to dealing with fake news. Policy Insights Behav Brain Sci. 2019;6(1):94-101.

[3] Tabak I. Post-truth GPS: Detour at truth, take the long route to useful knowledge. Educational Psychologist. 2020;55(3):181-6.

[4] Barzilai S, Mor-Hagani S, Zohar AR, Shlomi-Elooz T, Ben-Yishai R. Making sources visible: promoting multiple document literacy with digital epistemic scaffolds. Comput Educ. 2020;157:103980; Bromme R, Goldman SR. The public’s bounded understanding of science. Educ Psychol. 2014;49(2):59-69.

[5] Osborne J, Allchin D. Science literacy in the twenty-first century: informed trust and the competent outsider. Int J Sci Educ. 2024 Apr;1-22.

[6] Klein-Avraham I, Dabran-Zivan S, Baram-Tsabari A. Do you know sometimes the information is wrong? Knowledge about and usage of generative artificial intelligence in the early adoption phase [presentation]. 26th Annual Conference of the ISCA; 2024; Herzliya, Israel.

[7] Bandi A, Adapa PVSR, Kuchi YEVPK. The power of generative AI: a review of requirements, models, input–output formats, evaluation metrics, and challenges. Future Internet. 2023;15(8):260.

[8] Bang Y, Cahyawijaya S, Lee N, Dai W, Su D, Wilie B, et al. A multitask, multilingual, multimodal evaluation of ChatGPT on reasoning, hallucination, and interactivity. arXiv:2302.04023 [Preprint]. 2023 [posted 2023 Feb 8; revised 2024 Nov 28; cited 2024 Aug 12]. Available from: https://arxiv.org/abs/2302.04023.

[9] Shin D, Koerber A, Lim J. Impact of misinformation from generative AI on user information processing: how people understand misinformation from generative AI. New Media Soc. 2024. Available from: https://doi.org/10.1177/14614448241234040

[10] Rudolph J, Tan S, Tan S. War of the chatbots: Bard, Bing Chat, ChatGPT, Ernie and beyond. The new AI gold rush and its impact on higher education. J Appl Learn Teach. 2023;6(1):364-89.

[11] Statista [Internet]. Worldwide desktop market share of leading search engines [cited 2024 Aug 12]. Available from: https://www.statista.com/statistics/216573/worldwide-marketshare- of-search-engines/; Statcounter GS [Internet]. Statcounter global stats – Search Engine Market Share Israel [cited 2024 Sept 12]. Available from: https://gs.statcounter.com/.

[12] Central Bureau of Statistics [Internet]. Panel generator: social survey – internet usage frequencies [cited 2024 Aug 12]. Available from: https://www.cbs.gov.il/he/Pages/מחולל-סקר-חברתי-חדש.aspx

[13] Klein-Avraham I, Dabran-Zivan S, Baram-Tsabari A. Do you know sometimes the information is wrong? Knowledge about and usage of generative artificial intelligence in the early adoption phase [presentation]. 26th Annual Conference of the ISCA; 2024; Herzliya, Israel.

[14] Greussing E, Guenther L, Baram-Tsabari A, Dabran-Zivan S, Jonas E, Klein-Avraham I, et al. Mapping cross-national patterns: The use of generative AI in science-related information retrieval across seven countries [accepted presentation]. Public Communication of Science and Technology (PCST) China Symposium; 2024 Oct; Suzhou, China

[15] Allen M, editor. The SAGE encyclopedia of communication research methods. SAGE Publications; 2017.

[16] Braun V, Clarke V. Conceptual and design thinking for thematic analysis. Qual Psychol. 2022:9(1):3-26.

[17] Shenton AK. Strategies for ensuring trustworthiness in qualitative research projects. Educ Inf. 2004;22(2):63-75.

[18] Anney VN. Ensuring the quality of the findings of qualitative research: looking at trustworthiness criteria. JETERAPS. 2014;5:272-81.

[19] Allen M, editor. The SAGE encyclopedia of communication research methods. SAGE Publications; 2017.

[20] Britt MA, Rouet JF, Blaum D, Mills K. A reasoned approach to dealing with fake news. Policy Insights Behav Brain Sci. 2019;6(1):94-101.

[21] Kresin S, Kremer K, Büssing AG. Students’ credibility criteria for evaluating scientific information: the case of climate change on social media. Sci Educ. 2024;108(3):762-91.

[22] Klein-Avraham I, Greussing E, Taddicken M, Dabran-Zivan S, Jonas E, Baram-Tsabari A. How to make sense of generative AI as a science communication researcher? A conceptual framework in the context of critical engagement with scientific information. JCOM. 2024;23(06):A05.

[23] Zhang J, Liu Y, Cai W, Wu L, Peng Y, Yu J, et al. Investigation of the effectiveness of applying ChatGPT in dialogic teaching using electroencephalography. arXiv:2403.16687 [Preprint]. 2024 [posted 2024 Mar 25; revised 2024 June 11; cited 2024 June 11]. Available from: https://arxiv.org/abs/2403.16687.

[24] Milne-Ives M, de Cock C, Lim E, Shehadeh MH, de Pennington N, et al. The effectiveness of artificial intelligence conversational agents in health care: systematic review. J Med Internet Res. 2020;22(10):e20346.